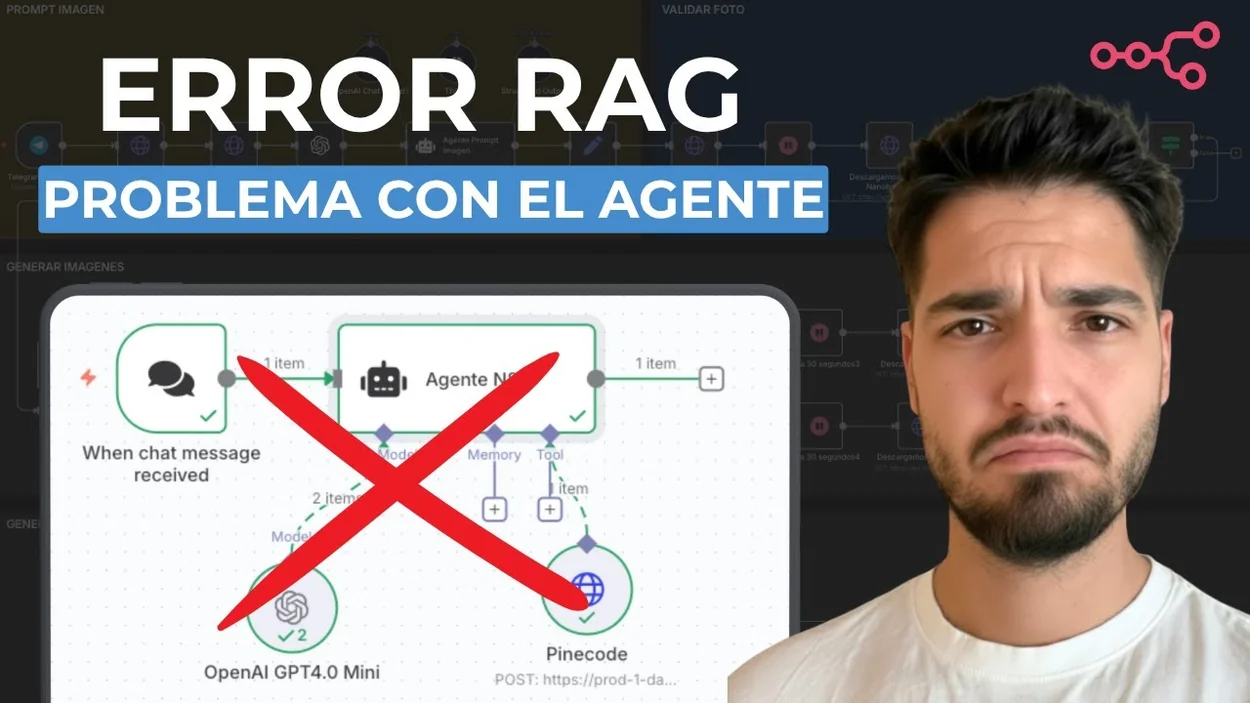
En este artículo te voy a enseñar por qué tu agente RAG en n8n puede estar fallando sin que te des cuenta, no por los prompts o el modelo, sino por algo tan simple como el formato del PDF que le estás dando de comer. Te cuento mi experiencia real con un proyecto y qué puedes hacer hoy para no caer en la misma trampa.
Mi caso real: cuando el RAG prometido se estrella contra un PDF
La petición de mi amigo
Ayer me contactó un amigo con una idea que parecía brillante. Quería un agente de inteligencia artificial donde pudiera meter todos sus libros y apuntes de la universidad para estudiar. La idea era que pudiera hacerle preguntas, preparar exámenes, resumir temas… todo lo que promete un RAG bien hecho, ¿vale?
Me puse manos a la obra, como suelo hacer. Le pedí los libros, me los pasó, y yo, confiado, me fui directo a n8n para montar el flujo.
El primer error silencioso
El problema empezó antes incluso de escribir el primer prompt. Cuando intenté subir sus PDFs a Pinecone, el proceso fallaba sistemáticamente. No daba un error claro, simplemente no procesaba nada. Lo mismo me pasó cuando probé con Supabase. La automatización que tengo para ingestar documentos se ejecutaba, pero la tabla de la base vectorial seguía vacía.
Yo ahí, pensando que había hecho algo mal en la configuración, revisando conexiones, claves API… hasta que me fijé en los propios archivos.
La diferencia entre un PDF ‘bueno’ y uno ‘malo’
Los libros que me había pasado mi amigo eran PDFs digitales, sí, pero no eran texto plano. Tenían demasiadas imágenes, gráficos, diagramas… y el texto a menudo estaba incrustado como parte de esas imágenes. Para una IA, eso no es más que un montón de píxeles sin sentido. Es como si tú le dieras una foto de una carta escrita a mano a alguien que solo sabe leer texto impreso. No va a entender nada.
Para contrastar, probé con otro PDF que tenía por ahí: un manual de usuario de MT4 (Metatrader 4). Este era básicamente texto con alguna que otra captura de pantalla. Se lo subí a Pinecone y, en segundos, estaba procesado y dividido en 51 fragmentos, listo para usar. En Supabase pasó exactamente lo mismo.
Ahí me di cuenta de la trampa. El problema no estaba en mi código, ni en el modelo de OpenAI, ni en el prompt. Estaba en la materia prima. Le estaba dando de comer piedras a una máquina que esperaba pan.
¿Por qué falla? No es el LLM, es la tubería de datos
El mito del ‘texto plano’
Cuando hablamos de RAG, todo el mundo se centra en el modelo, en los embeddings, en la búsqueda semántica… pero damos por sentado que el documento de entrada es texto legible por una máquina. Y ese es el primer error.
Un PDF no es solo un documento. Puede ser muchas cosas: un escaneado de un libro físico (una imagen), un documento creado a partir de capturas de pantalla, o un archivo con texto real y seleccionable. Los sistemas como Pinecone o los nodos de procesamiento de documentos en n8n suelen asumir que pueden extraer texto directamente. Cuando se encuentran con una imagen, se bloquean. Silenciosamente.
Cómo Pinecone y Supabase procesan (o no) los documentos
Estas herramientas no tienen un OCR (Reconocimiento Óptico de Caracteres) integrado y robusto por defecto. Intentan leer el PDF, si no encuentran texto, el proceso falla. A veces ni siquiera te avisan con un error claro; simplemente no ingresa nada en tu base de datos vectorial.
El resultado es que construyes un agente aparentemente funcional, con un flujo bonito en n8n, pero cuando un usuario pregunta sobre el contenido de ese libro escaneado, el agente no tiene nada que recuperar. Y aquí es donde empiezan los problemas graves: o te dice que no sabe (lo mejor que puede pasar), o, peor aún, inventa una respuesta confiada basada en su conocimiento general, alucinando citas y fuentes que no existen.
Esto no es una suposición mía. En la comunidad de n8n, un usuario reportaba exactamente este problema: su agente inventaba fechas y URLs que no coincidían con los metadatos reales de la base vectorial Mi agente RAG no funciona – Preguntas – n8n Community. El fallo no estaba en la recuperación, sino en que la recuperación no encontraba nada fiable y el modelo tapaba el agujero con imaginación.
El cuello de botella oculto: embeddings de imágenes
Podrías pensar: «y los modelos multimodales que ven imágenes, ¿no solucionan esto?». En teoría, sí. Pero en la práctica, hoy por hoy, no es viable para producción. Procesar cada página de un PDF como una imagen, generar un embedding visual, y luego hacer búsqueda semántica sobre eso es carísimo (en tokens y en tiempo) y tremendamente lento. No es lo para lo que están optimizadas las tuberías RAG actuales en herramientas low-code.
El cuello de botella no es la inteligencia, es la logística de los datos. Tu flujo es tan fuerte como el eslabón más débil, y a menudo ese eslabón es un PDF de 300 páginas escaneado en los 90. Es como tener una autopista de 10 carriles que termina en un camino de cabras. Da igual lo rápido que vayas antes, ahí te atasques.
Las soluciones que probé (y por qué no sirven para producción)
Herramientas de OCR y conversión PDF-to-text
Lo primero que haces es buscar un conversor. Hay mil herramientas, desde librerías de Python como pytesseract hasta servicios SaaS. Las probé.
El resultado, en mi experiencia, es una basura. Sí, convierten la imagen a texto, pero la calidad es impredecible. Errores de reconocimiento de caracteres (una «l» que se convierte en «1»), saltos de línea aleatorios, tablas que se desestructuran por completo. Metes un PDF de un libro de ingeniería lleno de fórmulas y te sale un galimatías.
Para un proyecto personal, quizás te valga. Pero para un agente en producción, donde la precisión es crítica, no es fiable. Estarías introduciendo ruido y errores directamente en tu fuente de conocimiento. Garbage in, garbage out, pero multiplicado. Y yo, que no soy experto en OCR, no puedo garantizar que no se me cuele un error que luego el agente repita como si fuera la verdad absoluta. Es un riesgo que no quiero asumir, ¿vale?
Procesamiento manual: la opción inviable
La opción «perfecta» sería tener a una persona que transcriba o verifique cada PDF. Obviamente, es inviable en coste y tiempo. Si tu caso de uso son unos pocos documentos estáticos, quizás puedas hacer este esfuerzo una vez. Pero si hablamos de escalar, de cientos de documentos que pueden actualizarse, es un camino sin salida.
¿Y los modelos multimodales? (Spoiler: no es la panacea)
Como te decía antes, los modelos que pueden ver imágenes (como GPT-4V) son una esperanza futura, pero hoy no son la solución. Primero, el coste. Procesar un PDF de 100 páginas como 100 imágenes es astronómico comparado con procesarlo como texto. Segundo, la latencia. Tardaría muchísimo más. Y tercero, y más importante, la fiabilidad en la extracción de texto largo. Un modelo multimodal es excelente para describir una foto, pero para extraer texto denso y estructurado de un libro escaneado con precisión, no está optimizado. No es su función principal.
Confiar en esto para producción hoy es, en mi opinión, un error. Es una capa más de complejidad y de puntos de fallo. Y ya tenemos bastantes, ¿no te parece?
Este no es un bug aislado: los otros modos de fallo del RAG en producción
El problema del PDF escaneado es solo la punta del iceberg. Cuando llevas un RAG a producción, especialmente si le añades capacidades de agente (que tome decisiones, que use herramientas), aparecen otros modos de fallo igual de silenciosos y peligrosos. No es que la IA «se equivoque más», es que la arquitectura es más frágil.
- Alucinaciones y citas inventadas: Esto ya lo hemos tocado. Cuando la recuperación falla o devuelve fragmentos pobres, el modelo, por diseño, completa la información. Inventa números de página, URLs, fechas. En el foro de n8n que te mencioné, el usuario tenía el problema de que el agente citaba un «Número 18 enero 2023» cuando la URL real era
december-2022Mi agente RAG no funciona – Preguntas – n8n Community. Esto destruye la confianza del usuario al instante. - Retrieval Thrash y Tool Storms: Cuando un agente tiene la capacidad de decidir «buscar de nuevo» si no está satisfecho, puede entrar en un bucle infinito. Sigue buscando sin converger, llama a herramientas en cascada, gasta tokens y tiempo sin llegar a una respuesta mejor. En los sistemas Agentic RAG, esto se llama ‘Retrieval Thrash’ y ‘Tool Storms’. Sin límites estrictos, tu agente se autosabotea.
- Errores 429 y límites de scraping en tiempo real: Si tu agente depende de buscar información en web en tiempo real (una herramienta muy común), se topa con la cruda realidad de internet: los límites de tasa (rate limits). Errores HTTP como ‘429 Too Many Requests’ y ‘403 Prohibido’ son pan de cada día cuando los sistemas de scraping son detectados Por qué los agentes se paralizan en la producción: cuando la recuperación en tiempo real se encuentra con la realidad | HackerNoon. Tu agente, en vez de responder, se queda colgado o devuelve un error técnico al usuario.
Estos no son fallos del LLM, son fallos de la orquestación. Y son los que hacen que un prototipo chulo en n8n se rompa cuando lo usan 100 personas al día. Es como montar un motor de F1 en un chasis de cartón, ¿vale? El motor tira, pero a la primera curva se desmonta todo.
Mi checklist para un RAG fiable (más allá del prompt)
Después de este golpe de realidad, he cambiado mi forma de abordar cualquier proyecto RAG. Ahora, antes de tocar el nodo del AI Agent, sigo estos pasos:
Paso 1: Auditoría de las fuentes de datos
Lo primero es inspeccionar TODOS los documentos que voy a usar. No me fío del nombre del archivo. Abro una muestra, intento seleccionar texto con el cursor. Si no se puede, es una imagen. Pregunto: ¿puedo conseguir una versión con texto real? ¿Es un escaneado? Si la fuente es defectuosa, todo lo que construya encima será inestable. Este paso me ahorra horas de debugging después.
Paso 2: Preprocesamiento determinista (no delegado al LLM)
Cualquier limpieza, extracción o normalización de los datos DEBE hacerse antes de que llegue al LLM. Uso reglas simples y código (o nodos de n8n como «Edit Fields», «IF», «Split Out») para extraer metadatos de forma fiable (nombre del archivo, fecha si está en el nombre), limpiar formatos raros y, lo más importante, convertir documentos no textuales a texto, pero con un proceso supervisado. Si uso OCR, reviso una muestra del resultado para ver la tasa de error. No lo dejo en manos de una librería mágica.
Paso 3: Guardarraíles y límites estrictos
En el flujo del agente pongo un límite máximo de llamadas a herramientas por consulta (por ejemplo, 3) para evitar bucles infinitos. Defino condiciones claras de parada («si la herramienta X devuelve ‘no results’, pasar directamente a la respuesta final»). Y configuro timeouts para cada operación externa (búsqueda web, consulta a API). Que falle rápido y controladamente es mejor que se quede colgado.
Paso 4: Observabilidad y tests de regresión
Esto es crucial. Creo tests automatizados (pueden ser simples webhooks que disparan preguntas clave) que verifican que la ingesta de documentos ha añadido X fragmentos a la base vectorial, hacen preguntas cuya respuesta está solo en los nuevos documentos y comprueban que la respuesta es correcta y cita la fuente adecuada, y simulan preguntas que NO deberían tener respuesta (fuera del conocimiento base) para verificar que el agente dice «no lo sé» en lugar de alucinar.
Sin esto, estás volando a ciegas. Un cambio en el formato de un PDF nuevo puede tirar abajo todo tu agente sin que te des cuenta hasta que los usuarios se quejen.
Conclusión: el RAG robusto empieza antes del primer embedding
La lección aprendida
La lección de todo esto es humilde pero poderosa: la magia del RAG no está en el prompt más ingenioso ni en el modelo más caro. Está en la calidad y preparación de los datos que le das. Un RAG robusto empieza antes de generar el primer embedding.
Podemos pasar horas ajustando instrucciones al modelo, pero si la tubería de ingesta falla silenciosamente con PDFs escaneados, todo ese trabajo es inútil. El problema no es de software, es de atención al detalle. De no dar por sentado que «un PDF es un PDF». Es un trabajo menos glamuroso, pero es el que separa el prototipo del sistema que aguanta en producción.
La invitación a colaborar
Yo, por ahora, mi solución es ser extremadamente selectivo con las fuentes. Si no es texto limpio, no va al RAG. Es una limitación, pero es realista. Reconozco que es una postura conservadora, pero prefiero un agente que funcione con el 80% de los documentos a uno que falle con el 100% porque intenté abarcarlo todo.
¿Tú has encontrado otra forma? ¿Has probado algún servicio de OCR que sea realmente fiable para producción? ¿Has implementado un preprocesamiento en n8n que funcione? Me encantaría saberlo.
Coméntalo aquí abajo. Igual podemos entre todos encontrar un enfoque mejor, porque este es un problema que nos va a afectar a todos los que queremos llevar la IA más allá del prototipo y a proyectos reales.