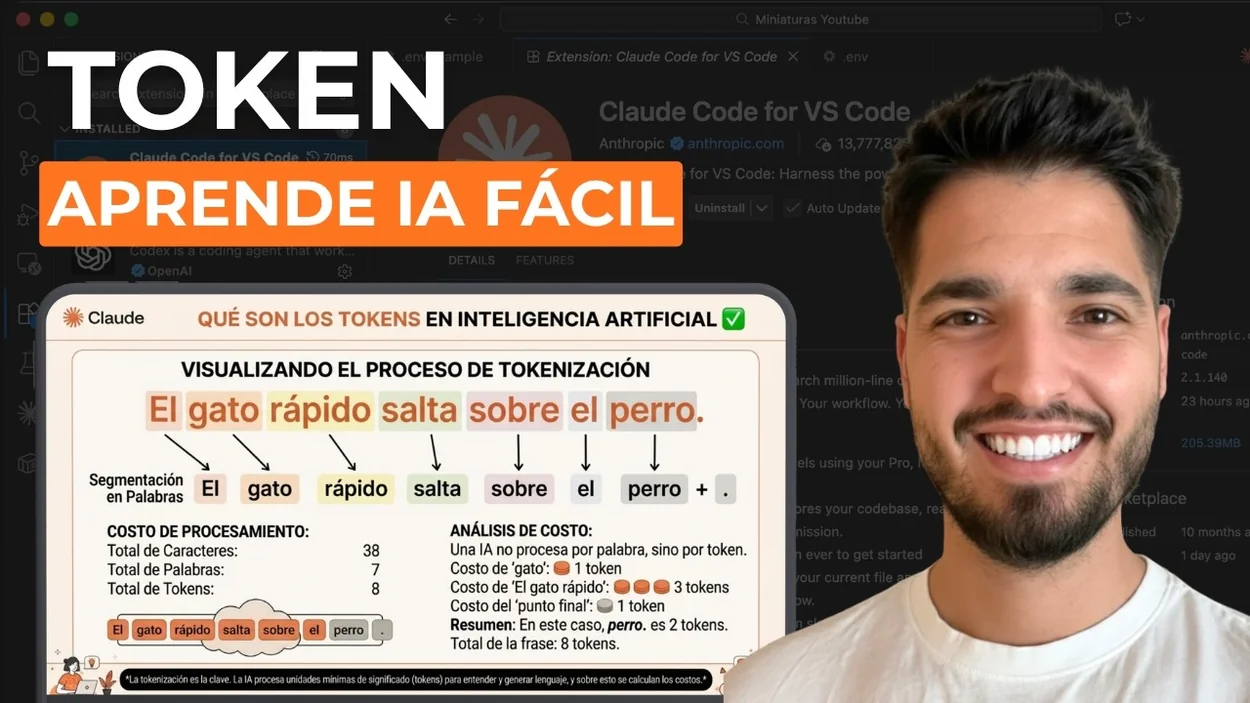
En este artículo te voy a explicar qué es un token, por qué gastas dinero cada vez que preguntas a una IA y cómo puedes ahorrar tokens para usar estas herramientas sin que se te dispare el coste, ¿vale? Te lo explico desde mi experiencia trabajando con proyectos de IA para mi canal de YouTube, donde gestiono documentos y prompts en plataformas como Claude para no tener que repetir el mismo contexto una y otra vez, ahorrando tokens en cada consulta.
Si no entiendes esto de los tokens, es como ir al mecánico sin saber que te cobran por hora de mano de obra y por piezas. Puedes salir con la cartera vacía y sin entender por qué.
¿Qué es un token? (No, no es una palabra)
Lo primero que tienes que entender es que un token es básicamente cómo te comunicas con la inteligencia artificial. Un token es el trozo mínimo de texto que procesa una IA.
Y ojo aquí, porque no es una palabra completa. Puede ser un signo, una sílaba o incluso un espacio, ¿vale? Todo cuenta.
Aquí te pongo un ejemplo práctico que uso en mis vídeos. La frase "Hola, ¿cómo estás?" se divide en 7 tokens. A veces un token es una coma, el signo de interrogación, una palabra entera de cuatro letras, y otras veces es una palabra de dos o incluso un signo de uno solo. Las palabras cortas como «casa» o «luz» suelen ser un token, mientras que las largas como «establecimiento» o «alojamiento» ya suelen tener dos tokens.
Para que te hagas una idea de la escala, en inglés hay una regla aproximada que dice que 1 token son unos 4 caracteres y 100 tokens son unas 75 palabras. Pero esto cambia mucho con el español. Nuestro idioma consume más tokens por frase debido a las tildes, los signos de interrogación iniciales y las conjugaciones más complejas. Parece una tontería, pero a escala, cuando estás trabajando con documentos largos, la diferencia de coste se nota.
Tokens de entrada vs. salida: por qué te cobran dos veces
Aquí está uno de los puntos que más gente pasa por alto, y es clave para no llevarte un susto. No solo pagas por lo que tú escribes.
Una cosa son los tokens de entrada (input), que son lo que tú le das a la IA: tu mensaje, un documento que subes, etc. Y otra cosa son los tokens de salida (output), que es lo que la IA te responde. El coste real es la suma de ambos.
¿Por qué es tan importante saber esto? Porque si le pides a la IA que te dé una respuesta larga, detallada y con ejemplos, estás pagando el doble: por tu pregunta (entrada) y por su respuesta extensa (salida). En cambio, si le pides algo concreto y le indicas que te responda de forma breve, solo pagas por una salida corta.
Como bien señalan algunos análisis, los tokens determinan el coste, la capacidad (ventana de contexto) y el comportamiento de los modelos. Los proveedores cobran por millón de tokens, así que cada token que ahorres, es dinero que te queda en el bolsillo.
El precio de los tokens: Claude, ChatGPT y la elección del modelo
No todos los modelos de IA cuestan lo mismo. Y usar el más potente para todo es como usar un martillo neumático para clavar un clavo: funciona, pero es un derroche bestia.
Te lo explico con Claude, que es el que más uso, pero la lógica sirve para cualquier plataforma. Tienen tres modelos principales: Haiku (el más sencillo y barato), Sonnet (intermedio) y Opus (el más potente y caro).
En mis vídeos suelo dar los precios aproximados por millón de tokens de entrada, pero aquí me tengo que corregir un error mío que es importante. Dije que Haiku rondaba los 0,80$, pero ese es el precio de salida. El precio de entrada de Haiku es mucho más bajo, unos 0,25$. Sonnet sigue rondando los 3$ y Opus los 15$ por millón de tokens de entrada. Ya ves que la diferencia es exponencial, pero confundir entrada con salida puede hacer que alguien facture mal, y eso es un lío. Yo al principio me pasaba, ¿eh? Usaba Opus para todo, hasta que vi la factura y me di cuenta de que era como ponerle gasolina de avión a un coche de ciudad.
La regla de oro que aplico siempre es: elige el modelo en función de la complejidad de la tarea. * Para tareas sencillas: Usa el modelo más barato. ¿Necesitas un resumen de un párrafo? ¿Una consulta factual simple como «¿quién fue el último rey de X?»? Con Haiku tienes más que suficiente y gastas una fracción. * Para tareas de complejidad media: Ahí entra Sonnet. Tal vez para analizar un texto más largo o generar un contenido con una estructura concreta. * Para tareas críticas o muy complejas: Aquí sí usas Opus. Por ejemplo, si estás programando una herramienta con Claude Code y necesitas que el código sea muy preciso y seguro. Usar Opus para una suma es tirar el dinero.
Esta elección no es solo por precio. Es por eficiencia. Gastar tokens de más ralentiza la respuesta y satura innecesariamente tu límite de uso.
4 formas prácticas de ahorrar tokens (y dinero)
Esto es lo que de verdad te va a hacer ahorrar, no solo en Claude, sino en ChatGPT, Gemini o la herramienta que uses.
Sé específico en tus prompts. No le des un prompt genérico del estilo «explícame todo sobre marketing digital con ejemplos». Es un disparo a ciegas que gasta tokens en divagar. En su lugar, sé concreto: «Dame tres estrategias de marketing digital para una tienda online pequeña de ropa». Le estás dando un marco, un objetivo claro, y la respuesta será directa y con menos tokens de salida.
No repitas contexto: usa proyectos y memoria. Esto es un game-changer y lo que más aplico en mi trabajo. No pegues el mismo documento en cada nueva conversación. Plataformas como Claude te permiten crear «Proyectos» donde subes archivos (capturas de pantalla, PDFs, textos) una sola vez. La IA los procesa (gasta tokens una vez) y luego, en conversaciones futuras dentro de ese proyecto, ya tiene ese contexto. No tienes que volver a explicarle todo desde cero.
Pide respuestas cortas cuando puedas. Directamente indícaselo. En lugar de «descríbeme en detalle», prueba con «respóndeme en dos frases» o «dame una lista breve de puntos clave». Controlas así los tokens de salida. Recuerda que una conversación con IA suele ser un diálogo: preguntas, respuestas, réplicas… y cada intercambio suma tokens. Si mantienes las respuestas concisas, el gasto total se reduce muchísimo.
Elige el modelo más barato que pueda con la tarea. Ya lo hemos visto, pero insisto porque es la base. Antes de lanzar cualquier consulta, pregúntate: «¿Realmente necesito la potencia de Opus para esto?» La mayoría de las veces, la respuesta es no.
La ventana de contexto y por qué tu IA ‘olvida’
¿Alguna vez has notado que en conversaciones muy largas la IA parece «olvidarse» de lo que hablaste al principio? Esto tiene que ver con el límite de tokens por conversación, lo que se llama la «ventana de contexto».
Cada modelo tiene un máximo de tokens que puede manejar en una sola sesión (input + output todo junto). Si tu conversación supera ese límite, el modelo literalmente deja de «ver» los primeros tokens para dar cabida a los nuevos. Es como si tuviera una memoria de trabajo muy corta.
Por eso, para gestionar documentos largos sin reventar el límite, hay que ser estratégico. No puedes soltarle una novela entera y esperar que la analice completa si supera su ventana. La solución es dividir el documento en fragmentos manejables y procesarlos por partes.
Aquí vuelve a ser crucial lo de los proyectos. Al subir un documento largo a un proyecto, el modelo puede acceder a su contenido de forma más eficiente dentro de esa ventana, sin que tú tengas que reenviar trozos constantemente.
Otro detalle importante es que la tokenización varía según el modelo y la codificación. El mismo texto puede tener un número de tokens distinto en GPT-4, Claude o Llama. Esto significa que un documento que «cabe» justo en la ventana de contexto de un modelo, podría no caber en la de otro. No des por sentado que porque un texto entre en uno, entrará en todos.
Mi experiencia: cómo gestiono tokens en mis proyectos de YouTube
Te lo cuento tal cual lo hago, para que veas que esto no es teoría. Para el canal de YouTube tengo un proyecto creado en Claude.
Dentro de ese proyecto subí, una sola vez, capturas de pantalla de cómo es el feed de mi canal, documentos con los protocolos que sigo para grabar y editar, las temáticas que trato y el tono que quiero mantener. Eso supuso un gasto de tokens inicial, sí.
Pero la ventaja es brutal. Ahora, cuando quiero consultarle algo tipo «¿con la métrica de este último vídeo, qué tema crees que debería tratar en el próximo?», no tengo que volver a adjuntarle las capturas ni explicarle de nuevo cuál es mi canal. Él ya tiene ese contexto cargado en el proyecto. Simplemente hago la pregunta y la respuesta es precisa y relevante para mi caso concreto, sin gastar tokens extra en re-explicar el background cada vez.
Esto me ahorra una cantidad enorme de tiempo y, sobre todo, de tokens en cada consulta. Es la diferencia entre tener que darle toda la historia clínica a un médico nuevo en cada visita, o ir a tu médico de cabecera que ya te conoce.
Conclusión: los tokens son tu moneda, gástalos con cabeza
Al final, usar estas herramientas no es magia, es matemática. Tokens = coste. Y una conversación normal con una IA no es un intercambio único, es algo exponencial. Le preguntas, te responde, tú replicas, él vuelve a responder… y cada ciclo suma tokens de entrada y de salida.
Si no tienes cuidado, puedes verte arruinando tu presupuesto en créditos sin darte cuenta, especialmente si usas los modelos más caros para tareas triviales y pides respuestas kilométricas. Yo lo he visto pasar, y por eso ahora soy tan insistente con esto.
El siguiente paso, si de verdad quieres ser eficiente, es que empieces a medir. Antes de lanzar un prompt, piensa: «¿Estoy siendo lo suficientemente específico? ¿Podría usar un modelo más barato? ¿Le he dicho que me dé una respuesta breve?».
Controlar los tokens es controlar el coste. Y entender el coste es lo que te permite usar estas herramientas de forma sostenible y profesional, sin sustos.
Si quieres seguir profundizando en cómo sacar el máximo partido a la IA sin complicaciones, te invito a que te suscribas al canal de YouTube, donde subo vídeos así de prácticos, sin rodeos.
Herramientas y recursos que menciono
Algunos de estos enlaces son de afiliado: si compras a través de ellos me llevo una pequeña comisión, sin coste extra para ti.